18:00 小程序的新版本刚过审上线,我同步把后端最新代码推上了生产;19:00,一场活动要正式开始。
我刷新了一下页面,报错出来了:
Unknown column 'xxx' in 'field list'
服务没有挂。进程活着,端口通着,容器也在跑。
挂的是它和数据库之间的那根线。
先把结论说了
部署时用的那份配置文件,把数据库指向了一台还没启用的服务器。
那台机器是计划中的新生产库,库还没迁过去,表里没有代码要的字段。代码发上去,连上了,然后就查不到东西了。
一句话:配置先行,数据没跟上。
结论就这么简单。但这么简单的一件事,为什么能一路穿过打包、合并、部署、启动,最后大摇大摆地对外提供服务?
这才是我想写的东西。
三个环境,一个半
我们一直说自己有 dev、test、prod 三套环境。
实际情况是:
- 开发和测试都在同一台服务器上;
- 所谓生产环境,用的是测试环境的那台服务器;
- dev 和 prod 的数据库在同一台 MySQL 上,只差一个库名前缀:
dev-xxx和xxx。
我们嘴上说有三个环境,实际上只有一个半。
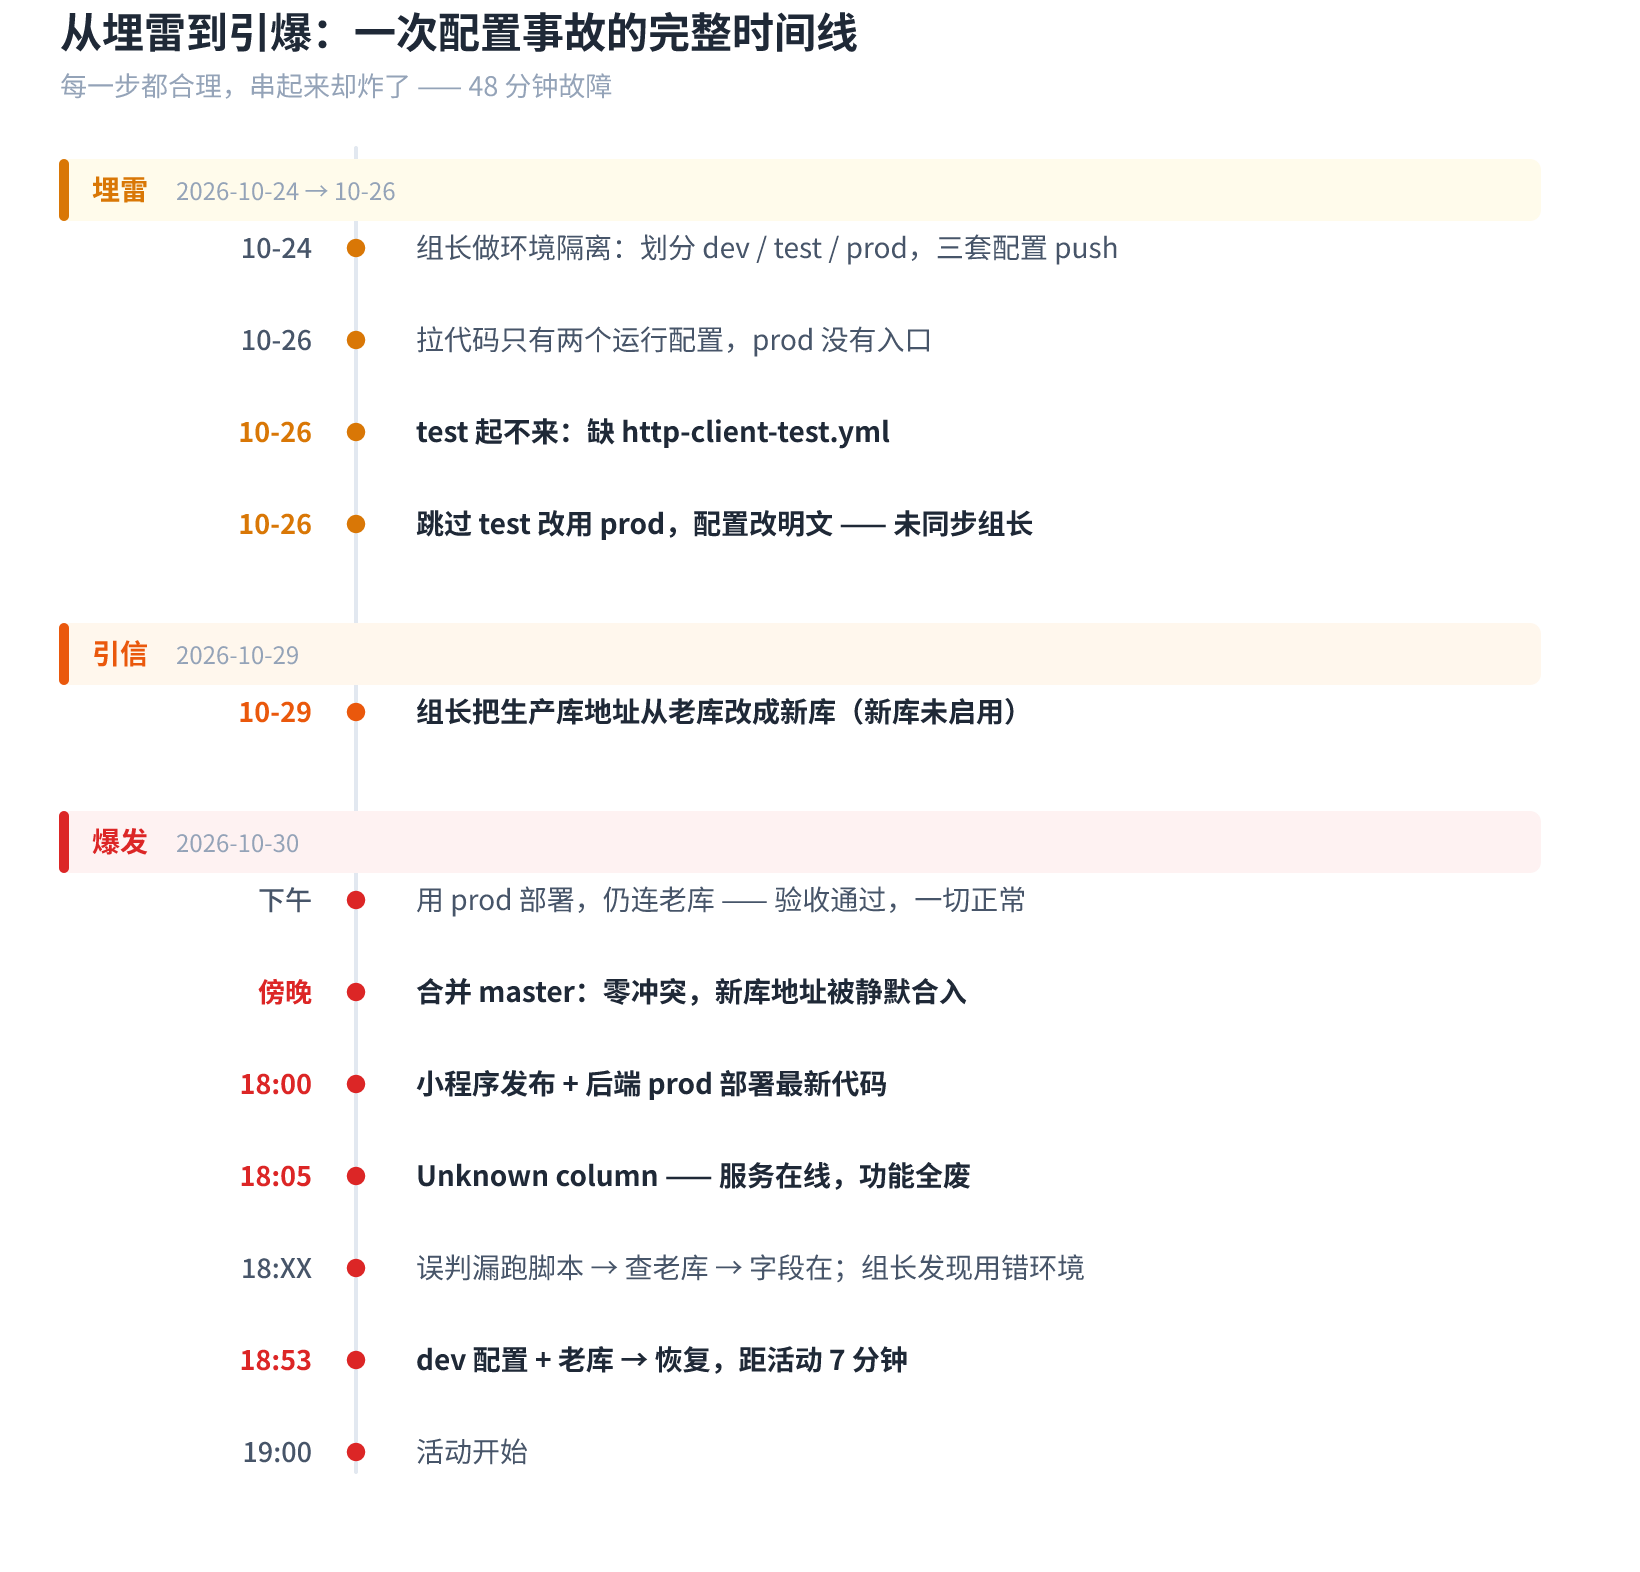
真正的隔离是在 10 月 24 日做的。组长划分了三个环境,把配置文件推到了远程仓库。
10 月 26 日,我拉代码,只看到两个运行配置:一个默认走开发环境,一个走测试环境,没有生产环境的入口。
我试着用测试环境启动,起不来——项目里少一个 http-client-test.yml,识别不了测试环境配置。
那时候我有两个选择:补上这个文件让它能跑,或者绕过去。我选了后者。
理由现在看起来很合理:既然是组长说"已经处理好了",那应该是测试过才提交的;现在不能用,可能是隔离还没做完;而且测试和生产本来就是同一台机器,跳过测试,直接上生产,好像也没什么区别。
于是我改了三个配置文件,把它们全部改成明文指定,不再依赖默认值。然后用生产环境启动,一切正常。
这件事我后来没跟组长说。
三个都讲得通的判断
回头看,我在那天做了三个判断。每一个单独拿出来,都站得住。
第一个:"他说做好了,应该是测过的。"
这是把一个二手结论当成了事实。组长确实说了"隔离处理好了",但他没有验证测试环境——它根本起不来。而我没有问,也没有自己跑一遍。
我把"他应该测过",当成了"他测过了"。
第二个:"测试环境不能用,是因为还没隔离好。"
这是一个更隐蔽的动作。系统明明用一次响亮的失败告诉我"这个环境是坏的",我却把它解释成了"施工中,正常"。
一个坏的测试环境,就这样被合理地保留了下来。
第三个:"测试和生产是同一台机器,跳过测试不影响。"
这里偷换了一个概念:环境不等于配置。
它们确实是同一台机器、同一个服务,但跑的是两套不同的配置文件。我跳过的不是一台机器,是那条配置的验证路径。
三个判断,没有一个是拍脑袋。它们都有依据,都讲得通。
事故就是被这样三个"讲得通",一路放行到了 10 月 30 日。
10 月 29 日,地址变了
查看 Git 提交记录,在 10 月 29 日组长改了一个文件。
application-prod.yml 里的 MySQL 地址,从老库改成了新库。
新库是计划中的生产服务器,目前还没启用,库也还没迁过来。他把地址先改了过去,推了代码。
从任何角度看,这都是正常工作的一部分——迁移总是要先把地址改过去。
唯一的问题是:没有人知道它被改过。
假平静
10 月 30 日早上,leader 给了我一个新任务:做活动模块的财务汇总。
下午,做完了,用生产配置部署上线,验收通过。
一切正常。
我那时候是真的觉得正常。因为那时候,配置里连的还是老库——新库的地址还在远程仓库里,静静地躺着,没有被任何一次部署触发过。
一次绿色的合并
活动汇总验收通过之后,我把当前分支合并到 master 并推到远程仓库。
Git 没有任何冲突,提示很干净。
就是这次合并,把 10 月 29 日那次改动合了进来。application-prod.yml 里的数据库,从老库变成了新库。
为什么 git 没有报冲突?
因为我改的是环境声明那几行,组长改的是数据源地址那一行。两处改动不在同一个位置,git 认为双方都改了、但不冲突,于是把两边的改动都保留了下来。
合并结果语法完全合法,语义已经错了。
「没有冲突」不等于「没有变化」。
Git 只负责文本层面的冲突,它不关心两个改动合在一起是否还成立。它给你一个绿色的结果,然后什么都不再说。
那时候,新库的地址就躺在我的仓库里,只是从来没进过我的脑子。
引爆
10 月 30 日 18:00,小程序最新版本审核通过,发布。
后端同步用生产配置部署了最新代码。
这是合并之后的第一次生产部署。
新库的地址,第一次生效。
18:05,报错开始。
误判
看到 Unknown column 的第一反应,是怀疑自己。
开发环境的数据库和线上数据库字段没对上,我少执行了一个加字段的脚本——这是我当时最相信的答案。
我立刻打开线上的数据库,比对字段。
字段是存在的。
第一个假设被推翻了。但我打开的是老库——因为在我脑子里,老库就是线上。新库那个地址,从来没有进入过我的排查范围。
我盯着屏幕看了一会儿。
字段明明在那里,为什么它说找不到?
只有一个可能:它连的不是这个库。
就在这个时候,组长走到了我工位旁边。
他看了一眼屏幕,说:"先重新编译看看。"
就是在这句话里,他看到了我用的是生产配置,而不是测试配置。
那一刻,两半真相撞在了一起:
- 他知道新库的存在——地址是他改的。但他不知道我一直在用生产配置部署,因为我没有说。
- 我知道测试环境是坏的,但我不知道数据库地址已经被改成了新库,因为我没有看。
我们两个人,各掌握一半真相。而这两半,从来没有在同一个房间里待过。
抢救:三个连环失误
组长下达了命令:用测试环境编译启动。
第一次失败。
端口被占用——原来的生产服务还在跑。
报错很清楚地写了端口冲突。我没有细看,以为又是别的问题,直接开始第二次。
第二次失败。
这次发现了是端口冲突。我做了一个决定:既然生产服务已经不可用,那就把 Docker 容器删掉,释放端口,再启动测试镜像。
报错只是"端口被占用"。docker stop 就能释放端口,而且随时能 start 回来。但我删了容器——从那一刻起,回滚的路就没有了。
容器删了,端口释放了,测试镜像启动了。
然后它报错:缺少 http-client-test.yml。
四天前我绕过去的那个坑,原样站在那里,连位置都没有挪。
在这四天里,没有人修它,也没有人问它——包括我。
到这一步,两条路并行:leader 觉得我这边编译慢,让组长用他的电脑编译;我这边想到了另一个办法——既然开发环境的代码能正常跑在线上,说明开发配置是好的,那就直接用开发环境部署,只要把 application-dev.yml 里的库名,从 dev-xxx 改成 xxx。
去掉一个前缀,就指向了真正的生产库。
因为它俩本来就在同一台服务器上。
系统喊了三次,人忙了三次。
10 月 26 日,它说"测试环境起不来",我解释成"还没隔离好"。
18:05,它说"找不到字段",我先去怀疑自己。
18:XX,它说"端口被占用",我连看都没看。
最亏的一笔
抢救的时候,我们一次又一次地重新编译。
一次编译,快的时候五分钟,慢的时候十几分钟。
但我们早就知道,问题出在数据库连接上,不是代码。既然是配置错了,完全可以复用已有的镜像,换一个数据库环境变量,几十秒就能起来。
问题在配置层,动作却在编译层。
那 48 分钟里,至少有两轮编译是白花的——一轮撞上端口冲突,一轮撞上缺失的配置。而最后真正解决问题的那个动作,改库名,本质上也是配置层面的改动,一样不需要编译。
习惯是会替人做决定的。"出问题就重新编译部署"是肌肉记忆,几乎没有人会在那一刻停下来问一句:这次真的需要重新构建吗?
而事故现场最缺的,恰恰是判断。
18:53
18:53,开发配置先起来了。
页面能打开了,接口通了,数据回来了。
七分钟后,19:00,活动开始。
从 18:05 到 18:53,48 分钟。
而在那之前,本来有一个 10 秒钟的动作可以避免这一切:打开那个文件,看一眼数据库地址。
残局
线上环境能跑了,但有些东西没有恢复。
- 线上那个容器,名字到现在还是
dev-开头; application-dev.yml里的数据库,还是指向生产库——因为线上的服务就是用它启动的;- 新库的迁移,后续再完善。
也就是说:现在任何一个人在自己电脑上跑一次开发环境,都会直接连上生产数据。任何一条按容器名前缀判断环境的运维脚本,都可能把线上服务当成开发环境清掉。
服务是好的,数据是生产的,配置是开发的。
我们把它救回来了,却没有把它放回原处。
部署前,30 秒
如果这件事能留下点什么,我希望是三个动作,每次部署前花 30 秒:
- 打开这次要用的 profile,看一眼 URL。 这次连的是哪个库?
- 确认镜像有没有版本号,上一版还在不在。 没有回滚路径的部署,不叫部署,叫赌博。
- 部署完打一个真实的请求。 不要只看容器状态——这次事故里,容器一直是健康的。
三条里,任何一条做到,这件事都不会发生。
最后一句:绿色的信号越多,人越不会去看细节。
Git 说合并成功,部署脚本说部署完成,容器说我还活着。所有信号都是绿的。
而这次事故的全部答案,就写在那个没人打开的文件里 url: jdbc:mysql://...。
本文涉及的公司、项目、人员均已脱敏。
评论